HMAC 签名为什么要做 Canonicalization:从 Query 排序到 Body Hash

从 Query 排序、重复参数、RFC 3986 编码到 Raw Body SHA-256,讲清 HMAC 请求签名为何需要规范化。
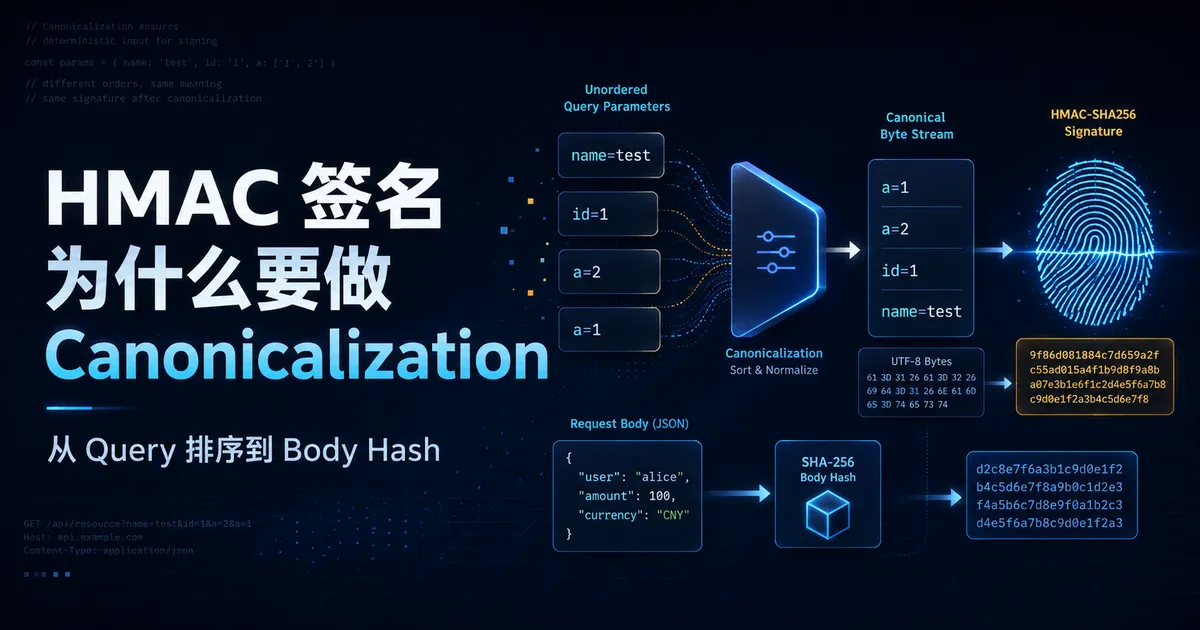
在设计 HMAC 请求签名时,我一开始的想法其实很直接:
客户端把 Token、MAC Key、Nonce、Timestamp、Query、Body 放在一起算一个签名,服务端再用同样的数据算一次,只要结果一致就说明请求可信。
这个思路本身没有问题。
真正麻烦的是:
客户端和服务端眼里的“同一个请求”,未必会对应完全相同的一串字节。
而 HMAC 对字节是极其敏感的。
只要有一个字符、一个空格、一个参数顺序不同,最终签名就完全不同。
所以一个真正可用的签名协议,不能只说“把请求参数拿去签名”,而必须继续回答:
- 参数按什么顺序?
- Query 怎么排序?
- 重复参数怎么办?
- 空参数怎么办?
- 空格到底编码成
%20还是+? - Body 是直接拿 JSON 字符串,还是重新序列化?
- Go、Java、Python 三个 SDK 怎么保证算出来完全一样?
这篇文章就是把这些我刚刚真正卡住的地方重新捋一遍。
问题从两个“完全一样”的请求开始
假设有两个请求:
POST /api/order?id=1&name=test和:
POST /api/order?name=test&id=1从业务角度来看,它们是一样的。
都是:
id = 1name = test但如果直接对原始 URL 做 HMAC:
?id=1&name=test和:
?name=test&id=1是两串不同的字节。
因此签名也不同。
这意味着一个很现实的问题:
客户端可能认为:
Signature = ABC服务端重新拼接参数以后,却算出了:
Signature = XYZ请求明明没有被攻击者修改,验签却失败了。
所以问题不在 HMAC 算法。
问题在于:
参与 HMAC 的输入没有被规范化。
Canonicalization 到底是什么?
Canonicalization 可以理解成:
把多种不同写法,但语义相同的请求,转换成唯一的一种标准表示。
例如:
?name=test&id=1和:
?id=1&name=test都统一转成:
id=1&name=test这个结果就可以叫:
Canonical Query之后客户端和服务端都只对这个标准结果签名。
这样就不再依赖:
- 客户端原始参数顺序
- HTTP SDK 拼接顺序
- Go map 遍历顺序
- Java Map 的实现细节
- Python 字典的构造过程
签名协议开始从“差不多能用”变成“可以跨语言稳定实现”。
Query 为什么不能直接使用 Go map 遍历?
这是 Go 里一个很容易踩的坑。
假设我们把 Query 参数存成:
map[string][]string然后直接:
for key, values := range params { // 拼接签名字符串}这是不能用来生成签名的。
因为 Go 的 map 遍历顺序不应该被当成稳定顺序依赖。
所以签名协议必须:
显式排序。
Canonical Query 的第一条规则:Key 排序
例如原始 Query:
?name=test&id=1&action=update先解析成:
name = testid = 1action = update然后按照 Key 升序排序:
actionidname最终:
action=update&id=1&name=testGo 中可以这样处理:
keys := make([]string, 0, len(params))
for key := range params { keys = append(keys, key)}
sort.Strings(keys)然后只遍历已经排序好的 keys:
for _, key := range keys { values := params[key]
// 继续处理 value}现代 Go 也可以使用:
slices.Sort(keys)但面试或者协议说明里说 sort.Strings 就足够清楚。
重复参数怎么办?
Query 并不一定是:
key=value一个 Key 只出现一次。
完全可能存在:
?id=2&id=1&name=test如果这时候把 Query 解析成:
map[string]string就可能直接把其中一个 id 覆盖掉。
所以更合适的结构是:
map[string][]string例如:
map[string][]string{ "id": {"2", "1"}, "name": {"test"},}然后除了 Key 排序,同一个 Key 下的 Value 也要排序。
例如:
id = ["2", "1"]排序后:
id = ["1", "2"]最终 Canonical Query:
id=1&id=2&name=test这样:
?id=2&id=1和:
?id=1&id=2都会得到相同的签名输入。
Value 排序在 Go 里怎么写?
最直接:
sort.Strings(values)不过这里有一个小细节。
如果:
values := params[key]sort.Strings(values)那么这个 Slice 很可能就是 Map 里原来的 Slice。
排序会修改原始顺序。
如果后续业务逻辑还需要保留原始参数顺序,可以复制一份:
values := append([]string(nil), params[key]...)sort.Strings(values)这样 Canonicalization 不会修改原始数据。
空参数不能偷偷丢掉
再看:
?id=1&name=这里:
name=应该参与签名。
因为:
?id=1和:
?id=1&name=最好被认为是两个不同的请求。
Canonical Query 应该保留:
id=1&name=而不是把空字符串参数直接删除。
同样:
?name和:
?name=协议最好也提前规定。
一个简单的方案是统一解释成:
name=重点不在于选哪一种规则,而在于:
协议必须明确,不允许不同 SDK 自己决定。
排序之后,还没有结束:URL Encoding 也必须统一
假设 Query 是:
keyword=hello world不同语言或者不同 URL 库,可能输出:
hello+world也可能输出:
hello%20world从 URL 表达角度看,它们在某些场景可能代表相同含义。
但在 HMAC 世界里,它们完全是两串不同字节。
因此签名协议还必须固定 URL 编码规则。
一个比较清晰的选择:UTF-8 + RFC 3986
可以规定:
Query 的 Key 和 Value 统一使用 UTF-8 编码,并按照 RFC 3986 percent-encoding 进行规范化。
不需要百分号编码的字符:
A-Za-z0-9-_.~其他字符统一进行 percent-encoding。
例如:
hello world统一变成:
hello%20world而不是:
hello+world再比如:
path=/a/b如果 /a/b 是 Query Value,那么可以规范化为:
path=%2Fa%2Fb百分号后的十六进制也最好统一规定使用大写。
Canonical Query 最终可以定成哪些规则?
把前面的内容放在一起,可以得到一套很清晰的流程:
1. 解析 Query,并保留重复参数2. Key 和 Value 使用 UTF-83. 按 RFC 3986 规则进行 percent-encoding4. Key 按升序排序5. 同 Key 的 Value 按升序排序6. 空 Value 保留为 key=7. 最终使用 & 拼接例如原始请求:
?name=&id=2&id=1最后生成:
id=1&id=2&name=这才是实际进入签名协议的 Query。
Body 又是另一个容易踩坑的地方
Query 解决以后,还有 Body。
假设客户端发送:
{"name":"test","id":1}服务端收到以后解析 JSON,再重新序列化:
{ "id": 1, "name": "test"}这两个 JSON 在业务语义上完全一样。
但是字节完全不同。
区别包括:
- 字段顺序
- 空格
- 换行
- 缩进
- 序列化实现
如果客户端对第一个 JSON 计算签名,服务端却对第二个 JSON 计算签名,验签一定失败。
所以这里不能简单说:
Body 转成 String 再签名。
因为“转成 String”到底是哪一种 String,本身就可能不稳定。
Body 不应该“先排序再签原始字节”
如果先:
解析-> 排序-> 重新序列化那得到的就已经不是客户端实际发送的原始字节。
如果真要让 JSON 语义等价的请求产生相同签名,需要定义完整的 JSON Canonicalization 规则。
包括:
- Object Key 排序
- Number 表示
- Unicode
- Escape
- Whitespace
- Boolean
- Null
复杂度会明显上升。
对于很多普通 API 网关来说,其实没有必要。
更简单的方案:直接对 Raw Body 做 SHA-256
一个更稳的设计是:
BODY_SHA256 = SHA256(raw_body_bytes)也就是:
客户端对自己真正发送出去的 HTTP Body 原始字节计算 SHA-256。
服务端也对:
自己真正收到的 HTTP Body 原始字节计算 SHA-256。
然后 Canonical String 里不直接放整个 Body,而是放:
BODY_SHA256例如:
POST/api/order1723194000abc123id=1&id=2&name=<body-sha256>然后再对整个 Canonical String 执行:
HMAC-SHA256(MAC_KEY, CanonicalString)为什么 Body Hash 比直接塞整个 Body 更合适?
第一,Canonical String 不会因为 Body 很大而无限膨胀。
第二,规则更统一:
JSONXML普通文本二进制都可以统一变成:
SHA256(raw_body_bytes)第三,它仍然可以保证完整性。
攻击者只要改动 Body 的任何一个字节,Body Hash 就会改变,最终 HMAC 也会改变。
两个语义相同的 JSON 会不会得到不同签名?
会。
例如:
{"name":"test","id":1}和:
{"id":1,"name":"test"}Raw Body 不同,所以:
BODY_SHA256不同。
最终签名也不同。
但这其实没有问题。
因为签名协议真正要保证的是:
客户端发送的字节,与服务端收到的字节完全一致。
而不是:
所有语义相同的 JSON 都必须有相同签名。
到这里,Canonical String 才开始像一个真正的协议
可以设计成:
HTTP_METHODCANONICAL_PATHTIMESTAMPNONCECANONICAL_QUERYBODY_SHA256字段之间固定用:
\n分隔。
然后进一步明确:
UTF-8最后是否允许换行空字段怎么表示Hash 使用 Hex 还是 Base64Hex 大小写因为 HMAC 签的不是一个抽象的 HTTP Request,而是一串非常具体的 bytes。
最后总结
这次真正让我理清的一点是:
HMAC 签名协议的难点,不是“怎么算 HMAC”,而是“签什么”。
如果 Canonicalization 没定义清楚:
GoJavaPythonGateway每一端都可能觉得自己的实现是对的,但最后算出来的 Signature 完全不同。
所以一个可靠的签名协议,至少应该明确:
Query:- 保留重复参数- Key 排序- Value 排序- 空值保留- UTF-8- RFC 3986 percent-encoding
Body:- 不解析后重新序列化- SHA256(raw_body_bytes)
Canonical String:- 字段固定- 顺序固定- 分隔符固定- 编码固定
HMAC 算法本身往往只有一行代码。
真正决定这套协议是否可靠的,是这一行代码之前的所有规范化规则。